 AI
Права доступа в корпоративном мозге: почему ACL файла больше не защищает то, что AI уже знает
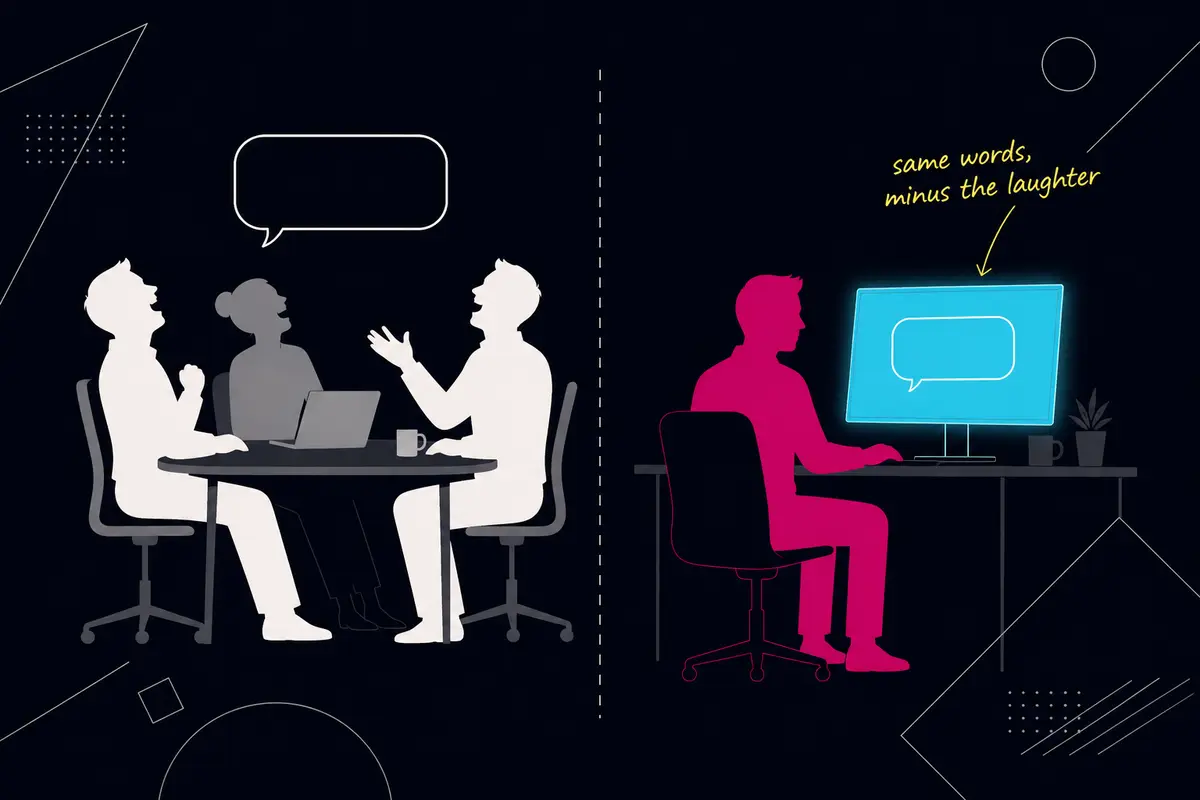
На общем созвоне кто-то пошутил про состояние роадмапа. Не злобно - просто устал человек, ляпнул что-то вроде «да мы этот релиз уже три квартала переносим». Все засмеялись и перешли к повестке. Через восемь месяцев новичок спрашивает корпоративный AI-поиск: «что со статусом роадмапа?» Система честно достаёт самое релевантное. Смеха в ответе нет.
Аккаунт-менеджер получает письмо от клиента: тот признаётся, что почти ушёл из-за кривого онбординга, но остался. Это ценнейший урок для команды продукта. Только вот отдавать команде весь инбокс аккаунт-менеджера никто не собирается - там ещё переговоры о скидках, личные договорённости, черновики эскалаций.
Инженер написал в трёх документах про архитектурные компромиссы. Агент прочитал, синтезировал и выдал коллеге: «он считает, что нужен монолит». Возможно, так и есть. Но права сказать «он сказал» у агента нет - он этого не говорил.
Все три истории про одно: информация ушла от объекта, а права доступа остались там. ACL - список, кто может открыть конкретный объект - по-прежнему охраняет файл, канал, папку. Но корпоративный мозг источник не возвращает. Он вытаскивает решение из созвона, склеивает с письмом, кладёт в память и через месяц отдаёт другому человеку. Единица прав доступа сменилась: раньше это был объект, теперь это утверждение - любой вывод, который система тащит дальше.
Рамку этого разбора задал текст Конора Бреннана-Бёрка «The Company Brain Has a Permissions Problem» (9 августа 2026). Честность требует сказать: Бреннан-Бёрк - фаундер Hyperspell (батч Y Combinator осени 2025), стартапа, который продаёт ровно это - слой памяти и контекста для AI-агентов, и его текст заканчивается предложением демо. Проблема от этого не перестаёт быть настоящей. Его ключевая формулировка заслуживает прямой цитаты: «Саммари отмывают права доступа. Выводы отмывают атрибуцию». Это точно схвачено - и стоит перед каждым, кто раскатывает Copilot, Glean или собственный RAG.
Почему старая модель держалась - и где она заканчивается
ACL отвечает на один вопрос: кто может открыть этот объект. Это пол, не потолок. Нет доступа к каналу - агент не должен по нему гулять. Ошибка - считать, что пол решает всё.
Серьёзные системы сегодня строят permission-aware RAG: RAG - это когда AI ищет по базе компании и подмешивает найденное в ответ, а «permission-aware» означает, что фильтрация по ACL источника происходит на этапе поиска, до того как документ попадёт в контекст модели. Это правильно и необходимо. Но вся эта обвязка защищает вход. Что происходит с правами после того, как модель сгенерировала ответ - за пределами этой архитектуры.
Google в 2019 году описал систему авторизации Zanzibar - права как граф отношений «кто кем кому приходится». На её идеях выросли открытые системы OpenFGA и SpiceDB. Но право в этой модели привязано к объекту. Саммари, собранное из пяти документов с разными правами, - новый объект, у которого прав нет: шага «вычислить права производного знания» модель не содержит, он остаётся на совести приложения.
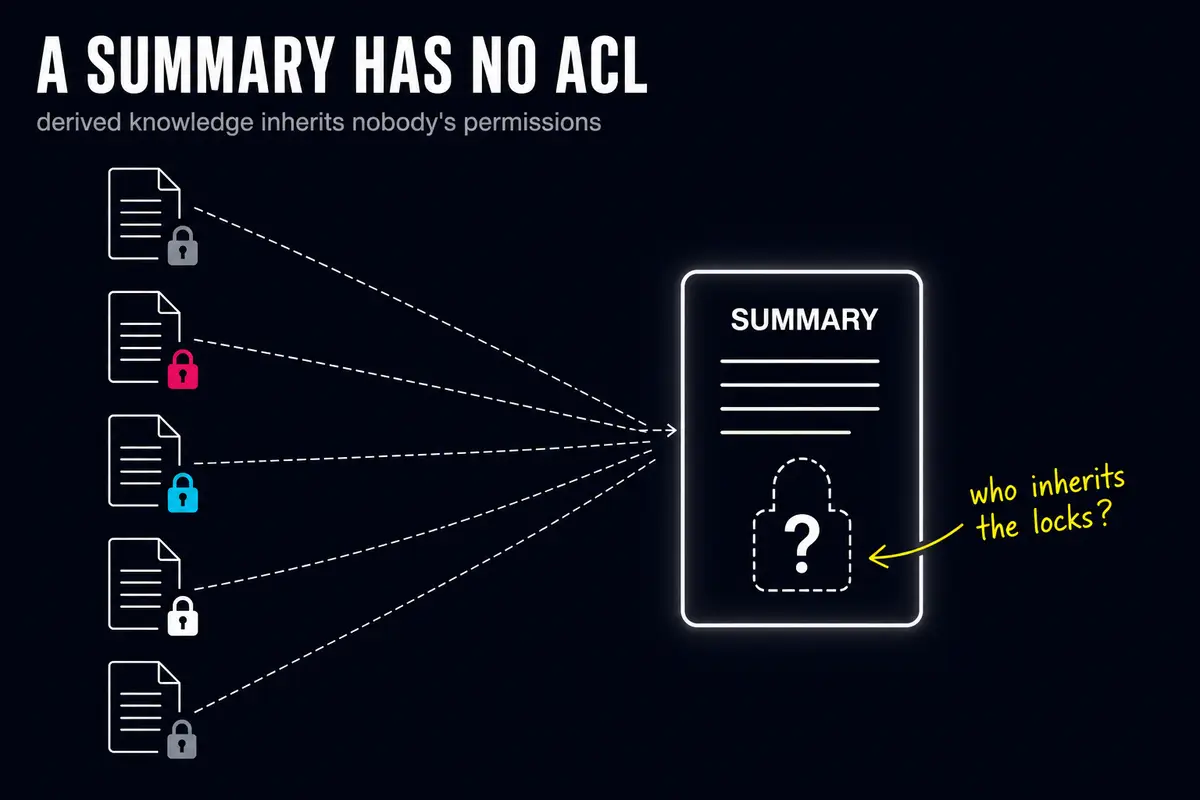
OWASP - организация, ведущая канонические списки рисков безопасности - внесла именно этот риск в топ-10 для LLM-приложений 2025 года: утечка при комбинировании данных с разными правами в одном контексте. Учёные дали проблеме имя в мае 2026: работа «Authorization Propagation in Multi-Agent AI Systems» на arXiv прямо пишет, что задача «не решается классическими моделями доступа - RBAC, ABAC или ReBAC», и выделяет «aggregation inference» - вывод из агрегата того, что нельзя было прочитать по частям.
Теперь про масштаб. По данным опроса Gartner (июнь 2024, 132 IT-руководителя), 40% организаций отложили раскатку Microsoft 365 Copilot на три и более месяца из-за страха oversharing - что поиск поднимет файлы, которые годами лежали открытыми. Business Insider в ноябре 2024 цитировал сотрудника Microsoft о жалобах клиентов: рядовой сотрудник включает Copilot - «и внезапно видит письма гендиректора». Microsoft в ответ выпустил отдельный гайд по борьбе с oversharing и платные инструменты для разгребания прав.
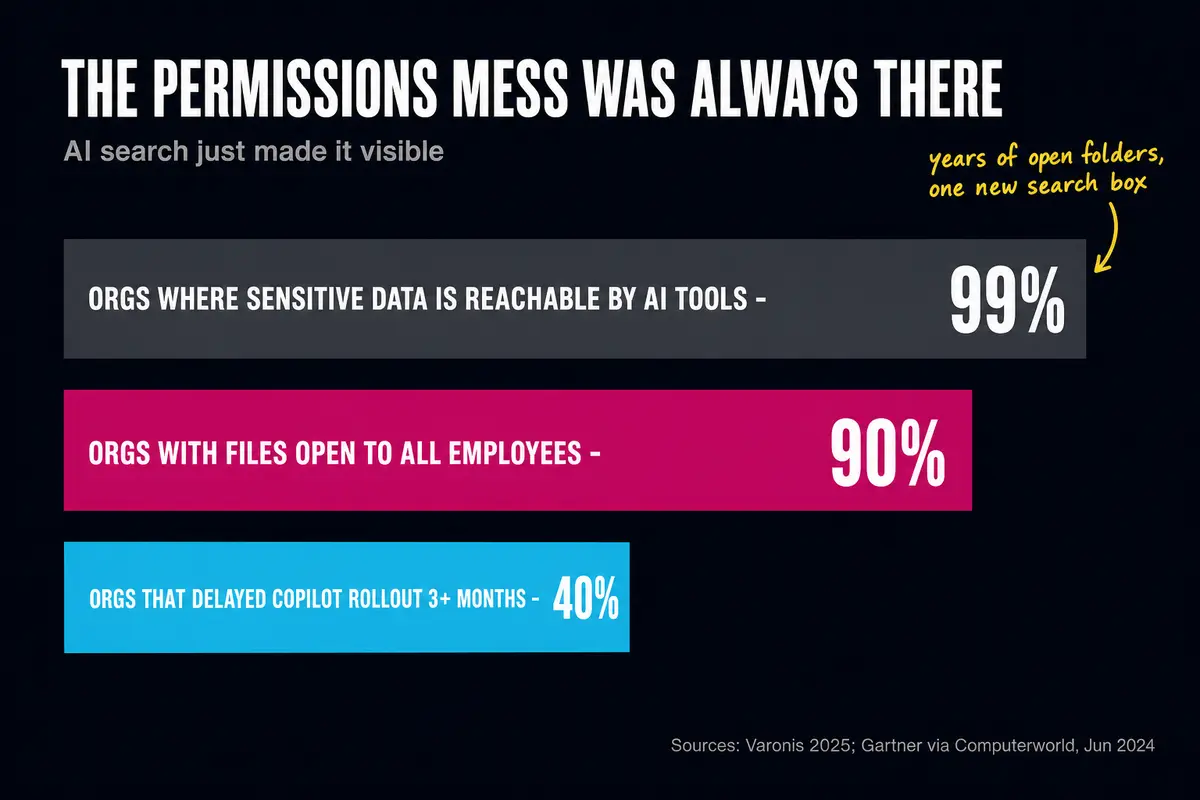
Varonis (2025, вендор защиты данных - интерес учитывать) даёт ещё более неприятную картину: у 99% организаций чувствительные данные технически доступны AI-инструментам, у 90% есть файлы, открытые всем сотрудникам, - в среднем 25 тысяч таких папок на компанию.
И вот тут начинается интересное. В августе 2024 исследователи PromptArmor разобрали Slack AI: поиск по умолчанию читал все публичные каналы, включая канал-ловушку, где сидел один атакующий с вредоносной инструкцией. Через неё можно было выманивать данные из приватных каналов жертвы. Slack сначала назвал чтение публичных каналов «задуманным поведением», патч вышел после огласки. В июне 2025 интеграционный сервер Asana больше месяца отдавал данные чужих организаций. Copilot умел читать файлы, не оставляя записи в журнале доступа - Microsoft тихо исправила это в августе 2025, не выдав CVE. То есть ломается даже «кто что смотрел».
Публичных именных разборов «сотрудник увидел лишнее через AI-поиск» почти нет - компании прячут такие истории под NDA. Тишина здесь сама по себе о многом говорит.
Иногда знание должно ехать дальше источника
Компания знает больше, чем видит любой её сотрудник. Продавец узнал в личном письме, почему клиент купил и почему отверг конкурента. Через полгода команда продукта спорит ровно об этом. Ей нужен урок - не инбокс.
Инженер нашёл обходной путь в закрытом канале. Через три месяца другой инженер ловит тот же баг. Второму нужен вывод; лезть во все разговоры канала за квартал ему незачем.
Механика здесь понятна: извлечь урок, срезать чувствительное, сохранить ссылку на доказательство, доставить тем, кому надо. Человечество этому научилось давно. Правило Chatham House сформулировано в 1927 году лондонским Королевским институтом международных отношений: полученную информацию можно свободно использовать, но нельзя раскрывать, кто и от чьего имени её сказал. Содержание едет, авторство остаётся. Простая и рабочая идея.
Автоматическая редакция существует и умеет больше, чем просто вымарывать. Google Cloud Sensitive Data Protection умеет сдвигать все даты на случайный, но одинаковый сдвиг - интервалы между событиями сохраняются. Умеет обратимо токенизировать данные, чтобы их можно было связывать, не видя реальных значений.
Но есть нюанс. Salesforce в Einstein Trust Layer маскирует персональные данные перед отправкой в модель и возвращает их в ответ после: пользователь видит реальные данные, модель работает с плейсхолдерами. Показательный поворот: для своих AI-агентов Salesforce это маскирование отключил - плейсхолдеры ломали точность агентов, что зафиксировано в блоге Salesforce за июнь 2025. Тупая редакция убивает урок, ради которого знание везли.
Исследовательский ответ на это уже есть. Работа на arXiv (декабрь 2024) описывает метод «правдивой санитизации»: чувствительные детали заменяются не заглушками, а правдивыми обобщениями уровнем выше, и кандидаты проверяются атакой теми же методами восстановления личности. Пользы заметно больше, чем от вымарывания, рост риска реидентификации - меньше одного процентного пункта.
Иногда знание должно ехать ближе источника
Первые пять минут любого созвона: кто-то рассказал про выходные, кто-то пошутил про коллегу, кто-то поныл про решение, которое считает дурацким. Потом началась встреча и было принято важное решение. Доступ к записи есть у всех участников - но не каждая фраза заслуживает стать вечной памятью компании. ACL источника это выразить не может в принципе: тут нужен смысл контента, а не список имён.
Люди ведут себя иначе, когда их записывают. После разоблачений Сноудена в июне 2013 года просмотры статей Wikipedia на чувствительные темы упали примерно на 30% и не вернулись к прежнему уровню больше года - это зафиксировано в рецензируемом исследовании Джонатона Пенни, опубликованном в Berkeley Technology Law Journal в 2016 году. Люди перестали даже читать легальное - от одного знания, что запись ведётся.
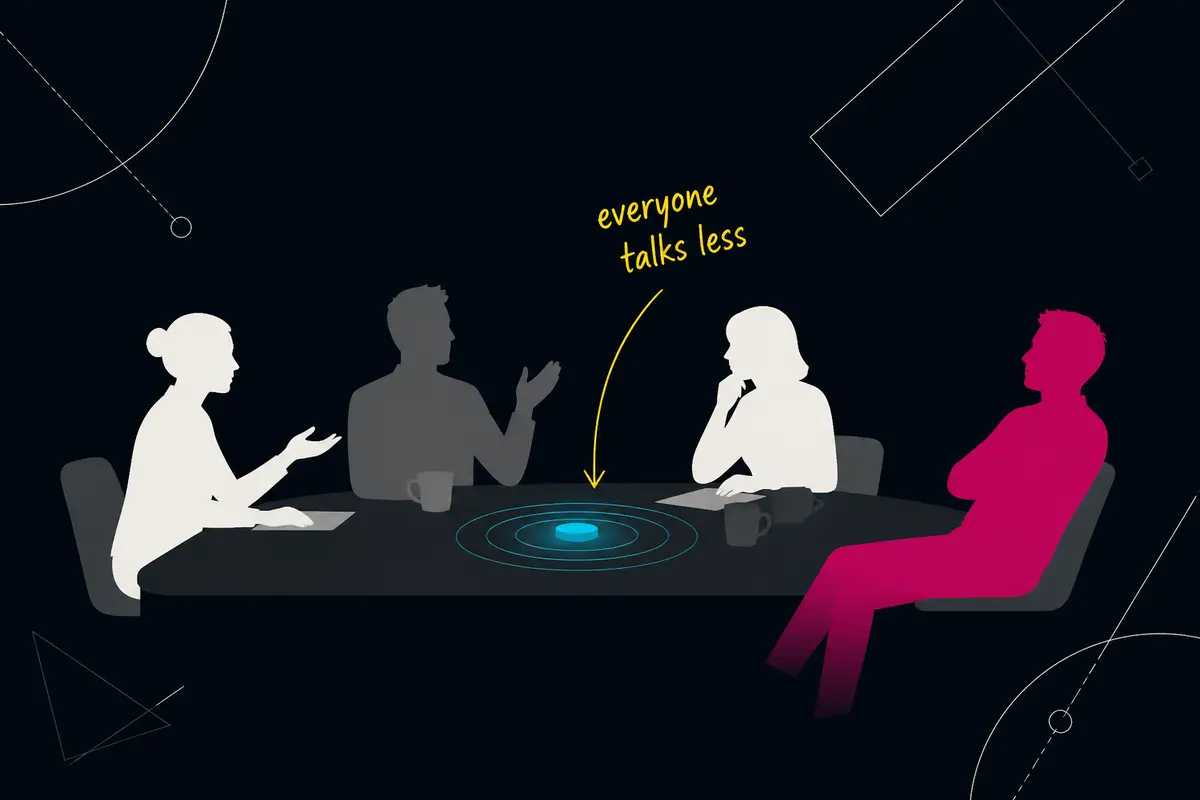
Про рабочие созвоны цифры такие: 84% пользователей AI-заметочников признают, что меняют то, что говорят, когда знают, что бот слушает; 47% сталкивались с тем, что бот записал или разослал лишнее - опрос Fellow 2025 года, производитель заметочника, интерес учитывать. Юрфирма Littler оценила в феврале 2026 года: час встречи - это примерно 16 страниц транскрипта. По опросу Американской психологической ассоциации 2023 года, среди сотрудников под электронным мониторингом 45% говорят, что работа вредит их ментальному здоровью; среди немониторимых - 29%.
Компания, которая пишет всё, начнёт фиксировать больше слов и понимать меньше.
Теперь юридическая вилка - и обе стороны реальны.
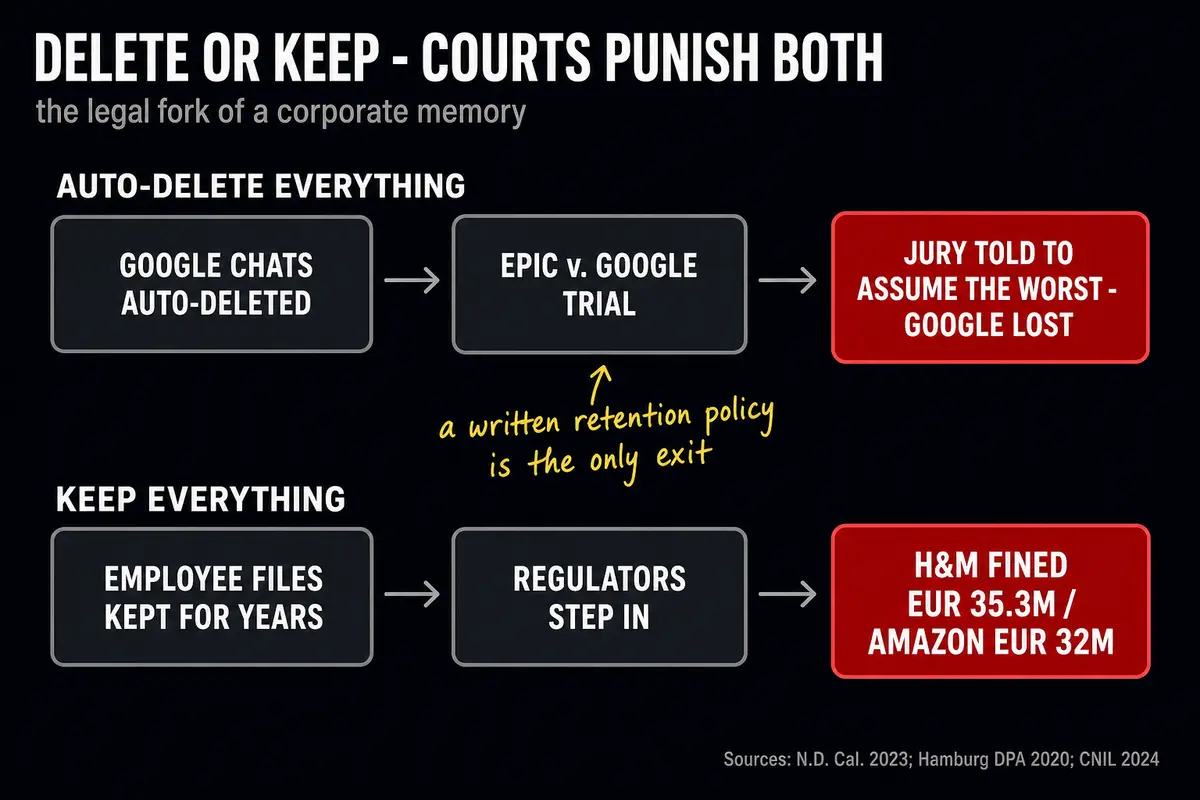
В деле Epic против Google суд наказал Google за авто-удаление внутренних чатов: в декабре 2023 присяжным разрешили считать, что удалённые чаты содержали невыгодные Google доказательства, и компания проиграла по всем пунктам. Судья по другому делу против Google написал в августе 2024: «В этот раз Google избежала санкций. В следующий может не повезти». Это сторона «удалять нельзя».
Сторона «помнить всё опасно»: немецкий регулятор оштрафовал H&M на 35,3 млн евро в 2020 году за досье на сотрудников - вплоть до диагнозов из разговоров. Французский регулятор оштрафовал складское подразделение Amazon на 32 млн евро в январе 2024 года за посекундный трекинг работников с хранением данных 31 день. GDPR прямо требует минимизации данных и ограничения хранения (статья 5). Вечная память - это ещё и вечный discovery: всё записанное можно истребовать в американском суде в рамках принудительного раскрытия внутренних документов.
В США обсуждение зарплат и условий труда защищено законом (NLRA, раздел 7), и слежка за такими разговорами - классическое нарушение. Мемо NLRB 2022 года о цифровом мониторинге отозвано в 2025-м, но сама доктрина осталась действующим правом.
Селективное забывание - часть хорошего корпоративного мозга, а вовсе не способ прятать неудобное.
Трейсы агентов - это новые записи созвонов
Инженер три часа работает с кодовым агентом. На выходе - pull request. По дороге агент читал файлы, отвергал подходы, натыкался на ограничения, получал правки от инженера. PR - финальный артефакт; трейс (полный журнал действий и рассуждений агента) - «почему». Встречи ведь и начали записывать потому, что разговор до решения содержит полезное. С агентами ситуация та же.
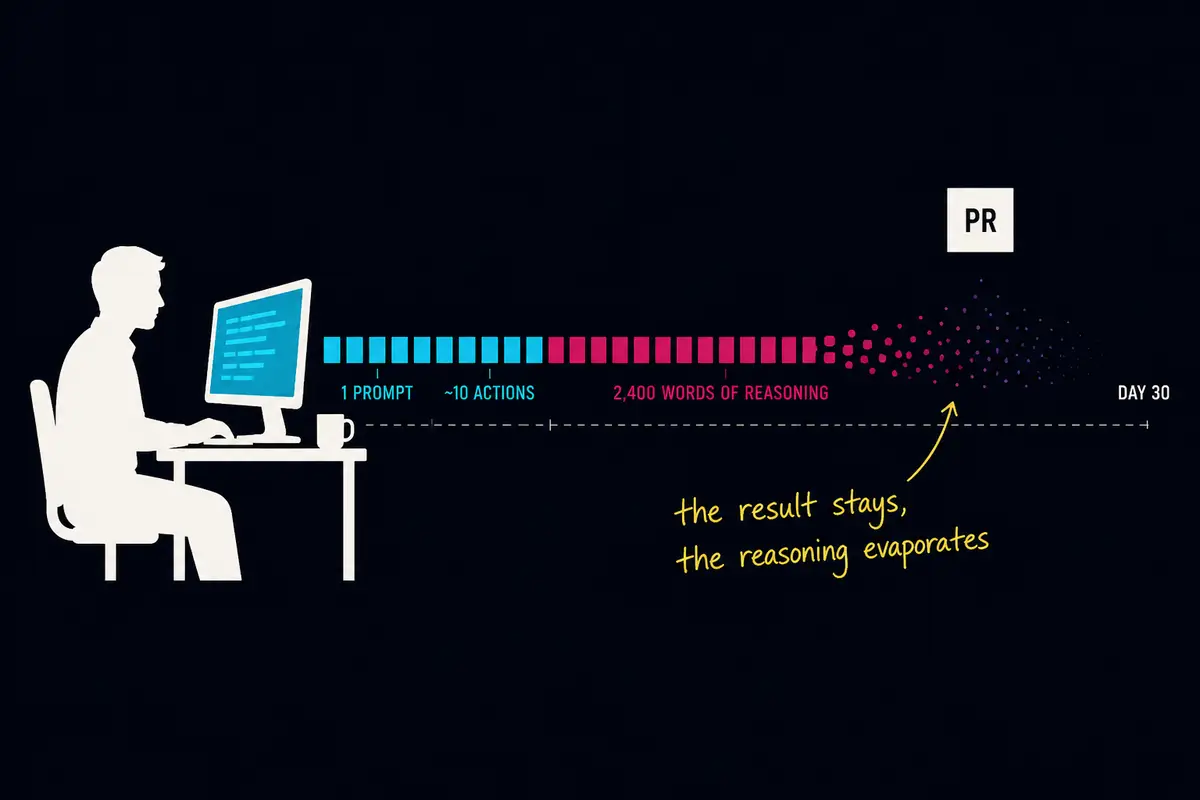
Масштаб, который исследование Anthropic зафиксировало на ~400 тысячах реальных сессий в 2026 году: один запрос человека запускает в среднем около 10 действий агента, иногда больше 100, и около 2400 слов рассуждений за ход. При этом дефолт индустрии - выбросить: стандартная настройка популярного кодового агента удаляет транскрипты сессий через 30 дней.
По данным New York Times за март 2026 года, активные инженеры прогоняют через агентов от 1 до 10 млрд токенов в неделю - токены здесь единицы оплаты работы модели; один инженер поставил рекорд в 210 млрд токенов за месяц. Хранить каждый токен не нужно и опасно.
Трейсы набиты секретами. Microsoft разобрала случай в июне 2026 года, когда кодовый агент в CI-пайплайне через вредоносный текст в задаче читал переменные окружения мимо песочницы - утекали ключи, а агента ещё и учили «отмывать» ключ, чтобы не сработал сканер секретов. В стандарте телеметрии OpenTelemetry запись содержимого промптов и ответов - строго opt-in с дефолтом «не записывать», и вся спецификация до сих пор в статусе «в разработке». Индустрия сама не решила, что из «почему» хранить.
Полезный объект - история решений: достаточно доказательств, чтобы восстановить ход, плюс то, что заслуживает стать памятью. У инженеров для этого есть прото-паттерн - architecture decision records, записи архитектурных решений; появились и агентные версии, где запись делает сам агент в момент выбора.
Проблема владения острая. Сотрудница уходит. Знание о том, почему упала миграция и как устроено исключение для клиента, принадлежит компании. Разговор, в котором она с агентом готовила чьё-то перформанс-ревью, - нет. Разделять надо в момент создания контекста: на оффбординге поздно. Юрфирма Brownstein в июле 2026 года отмечает, что оффбординг-процедуры заточены под файлы, а негласное знание теперь живёт в промптах и сессиях. Ни один суд пока не решал, кому принадлежит знание, рождённое в работе с агентом.
Атрибуция - часть прав доступа
«Инженер сказал X» весит больше, чем «система вывела X из его документов». Разница между этими фразами относится к правам, не к вежливости.
Прямая речь требует доказательства: письмо, транскрипт, кусок документа, где это действительно сказано. Иначе система обязана говорить своим голосом: «выведено из трёх документов». Это различие про природу утверждения, а не про стиль.
Стандарт происхождения данных W3C PROV существует с 2013 года и формально различает «процитировано из» (wasQuotedFrom) и «выведено из» (wasDerivedFrom). Инфраструктура для честной атрибуции придумана давно - её просто не применяют к памяти AI-систем.
Масштаб проблемы BBC измерила на собственном материале. Месяц тестирования AI-ассистентов на новостях BBC (февраль 2025): 13% цитат, которые ассистенты «взяли из статей BBC», были изменены или вообще не существовали в статье. Расширенное исследование Европейского вещательного союза и BBC (октябрь 2025, 22 вещателя, 14 языков, более 3000 ответов): у 31% ответов - серьёзные проблемы с указанием источника, у 45% - хотя бы одна значимая проблема.
Приватное письмо не становится публичным оттого, что агент его пересказал. Вывод не становится цитатой оттого, что его повторили три раза. История обязана переживать трансформацию.
У прав есть часы
Команда готовит запуск новой льготы для сотрудников. Готовящим знать надо сейчас. Остальной компании - на общем созвоне в пятницу. После анонса можно рассказывать кандидатам. Факт не изменился - изменилась уместная аудитория. Это намерение почти никогда не записано: человек думает «объявлю сам» и не ставит флаг эмбарго.
Человечество умеет работать с временными правами. Научные журналы десятилетиями работают по эмбарго: журналисты получают статью заранее, право публиковать включается в назначенный час. У инсайдеров публичных компаний право торговать акциями включается через 2-3 дня после квартального отчёта и выключается за 2-3 недели до конца квартала - обзор Harvard Law School 2021 года. Права со встроенными часами - обкатанная практика. Просто никто не перенёс её в корпоративную память агентов.
Иногда система обязана спросить человека. Сложность - когда именно перебивать, потому что система, которая спрашивает каждые пять минут, приучает людей её игнорировать. Врачи отклоняют 90-95% лекарственных предупреждений в медицинских системах - классическое исследование 2009 года, диапазон 49-96% по обзору 2020-го. Аналитики центров кибербезопасности не успевают обработать 67% предупреждений при 83% ложных срабатываний - данные Vectra за 2023 год. Когда сигналов слишком много, человек перестаёт реагировать на все.
Рабочий порог - обратимость. Поделиться наблюдением с коллегой обратимо. Отправить письмо клиенту или опубликовать наружу - нет, и это требует другой планки согласования.
Одна компания - лёгкий случай
Почти все системы прав предполагают одну организацию и одного администратора. Агенты это ломают: агент покупателя говорит с системами вендора, корпоративный агент работает с личным агентом сотрудника, саппорт-агент превращает внутреннее знание во внешний ответ.
«Внутреннее против внешнего» - слишком грубое деление. Подписанный контракт клиента авторитетнее поля в CRM. Утверждение, выведенное агентом чужой компании, годится для ресёрча и не годится как единственное основание для необратимого действия. Контекст должен нести свою авторитетность с собой - но механики для этого пока нет.
Техническая база не готова, и это признают сами стандарты. Спецификация MCP - протокола подключения агентов к системам - сама документирует проблему «запутанного заместителя»: посредник может получить токены без согласия пользователя. Черновик IETF прямо пишет, что стандартные OAuth-потоки не трактуют агента как отдельную идентичность. Токены, несущие политику с собой - macaroons, идея Google 2014 года, и verifiable credentials, стандарт W3C с мая 2025, - существуют, но массового применения в агентных системах пока нет.
Протокол общения агентов A2A дорос до версии 1.0 с криптографической проверкой личности агента; его поддерживают больше 150 организаций по данным Linux Foundation за апрель 2026 года. Но трезвая оценка такая: публично подтверждённых сделок «агент компании А договорился с агентом компании Б» на середину 2026 года нет.
В проде годами живут переговоры «AI против человека». Бот Walmart с 2021 года сам договаривается с поставщиками: в пилоте закрыл сделки с 64% из них со средней экономией 1,5% - Harvard Business Review, ноябрь 2022. Разрыв - ровно в идентичности и делегировании между организациями. Как только агент начинает говорить от имени компании с внешним агентом, вопрос «а что ему можно знать и передавать?» становится юридическим - техникой он уже не ограничивается.
Что с этим делать
Принцип один: политика едет вместе с утверждением. Права источника - точка старта; дальше политика должна ехать сквозь пересказ, склейку, запоминание и передачу.
Минимум, который корпоративный мозг должен знать про каждое долгоживущее утверждение: откуда пришло и сказано это или выведено; кто может получить; для чего можно использовать; сколько живёт в памяти; когда аудитория может измениться; какие действия агент вправе совершать на этом основании; когда решение принимает человек.
Это по-настоящему неудобная часть: фрагменты уже существуют, целого нет. У системы памяти Mem0 есть срок жизни записи и флаг «сказано/выведено». У Zep - метки «когда стало правдой» и «когда перестало». У Letta - блоки «только для чтения». Но прав доступа на уровне отдельного факта нет ни у одной из главных систем памяти агентов - Mem0 летом 2026 официально отказался делать видимость фактов механизмом изоляции. «Политика, прикреплённая к данным» существует с 2011 года - sticky policies, стандарт OpenTDF из мира спецслужб - но на уровне файла, не утверждения. Дыра подтверждена, инструмента нет.
Главное ограничение: ретрофитом это не чинится. Год работы неразборчивого мозга - это год памяти, которую нельзя отозвать: шутки, нытьё, полусырые мнения, выводы, ставшие «цитатами». И это год обучения людей тому, что система делает с их словами. Когда сотрудники поняли, что всё становится вечным и находимым, они начинают говорить иначе - и откровенность не возвращается после починки модели прав.
Понимание накапливается. Недоверие тоже.
Частые возражения
«Оверинжиниринг. Хватит ACL плюс не подключайте чувствительные источники».
Ровно это и предлагается как пол - и это правильный первый шаг. Вопрос в том, что делать с синтезом, который уже произошёл. Саммари из пяти документов с разными правами уже создано, уже лежит в памяти агента, уже отдано кому-то. ACL источников его не описывает - у него нет ACL. Синтез сам по себе не беда. Беда в том, что права производного знания никто не считает.
«Селективное забывание - удобная отговорка, чтобы прятать неудобное».
Сильное возражение, и его надо держать в голове. Разница между политикой хранения и уничтожением улик проходит по двум вещам: кто и когда решает, и остаётся ли доказательство. Политика, записанная заранее и применяемая ко всем одинаково, - это retention policy. Удаление задним числом под конкретный спор - spoliation: именно за это Google получила инструкцию присяжным против себя в деле Epic. Сам механизм чист, а вот применение может быть грязным - и это надо проектировать явно.
«Это продажа Hyperspell».
Да, источник рамки заканчивается демо-оффером, и мы сказали об этом в начале. Проблема при этом настоящая и стоит перед всеми, кто раскатывает корпоративный AI-поиск - на любом стеке. Gartner, OWASP, arXiv и кейс Slack AI не связаны с Hyperspell. Интерес источника не отменяет его правоту - просто проверять её приходится отдельно.
Вопросы и ответы
Мы уже раскатали корпоративный AI-поиск - что проверить в первую очередь?
Три вопроса, которые стоит задать прямо сейчас. Первый: что система делает с синтезированными ответами - куда они уходят, кто их видит, сколько живут? Второй: есть ли в памяти агента флаг «это сказано напрямую» против «это выведено»? Если нет - система не различает цитату и интерпретацию. Третий: какие источники технически доступны агенту, даже если вы не планировали их подключать - Varonis показывает, что в среднем 25 тысяч папок открыты всем. Начните с аудита того, что агент может прочитать, а не только того, что вы хотели ему показать.
Значит ли всё это, что записывать встречи не надо?
Нет. Записывать встречи полезно - вопрос в том, что происходит с записью дальше. Транскрипт, который лежит у участников и не уходит в корпоративную память агентов, - одна история. Транскрипт, который становится обучающим материалом для системы, которую спрашивают все сотрудники, - другая. Полезный минимум: явная политика того, что из записи попадает в долгосрочную память, и флаг на этапе создания контекста, а не на оффбординге.
Какие поля должны быть у каждого факта в памяти агента?
Семь минимальных полей: источник и тип (сказано прямо или выведено); список, кто может получить; разрешённые использования; срок жизни в памяти; условие смены аудитории; список действий, которые агент вправе совершать на этом основании; флаг «требует подтверждения человека». Ни одна из главных систем памяти агентов сегодня не реализует все семь - такова реальность рынка на сегодня.
Достаточно ли просто не подключать чувствительные источники?
Это необходимое условие, но не достаточное. Проблема агрегации - aggregation inference - означает, что три несекретных источника в комбинации могут раскрыть то, что по отдельности секретным не считалось. OWASP выделил это отдельным риском именно потому, что фильтрация на входе его не решает. Плюс: «чувствительный» - это не свойство источника, это свойство конкретного утверждения в конкретном контексте. Шутка про роадмап не чувствительна. Шутка про роадмап, ставшая фактом в ответе новичку через восемь месяцев, - уже другой разговор.
Majento строит AI-агентов и внедряет их внутри компаний-клиентов по модели forward-deployed: инженеры встраиваются в процессы, находят узкое место, собирают систему и остаются до результата. Централизованный контекст для агентов с доступами по проектам - часть нашего фреймворка AI-трансформации, и права мы проектируем на входе, а не ретрофитом. Если хотите разобрать свой стек - пишите в Telegram t.me/shimaoz или на hello@majento.ai.
Источники
- Публикация автора в X
- Материал businessinsider.com
- Материал computerworld.com
- Материал promptarmor.substack.com
- Материал genai.owasp.org
- Материал arxiv.org
- Материал chathamhouse.org
- Материал salesforce.com
- Материал arxiv.org
- Материал lawcat.berkeley.edu
- Материал americanbar.org
- Материал bbc.com
- Материал anthropic.com
- Материал nytimes.com
- Материал microsoft.com
- Материал w3.org
- Материал bbc.com
- Материал ebu.ch
- Материал corpgov.law.harvard.edu
- Материал vectra.ai
- Материал hbr.org
- Материал linuxfoundation.org